Introducción a la observabilidad en n8n
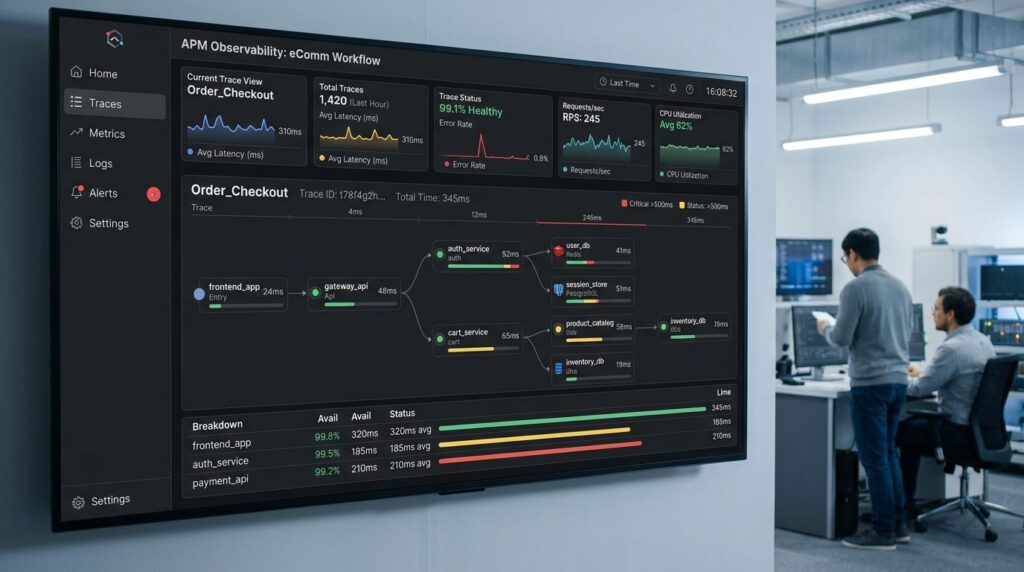
La observabilidad en automatizaciones de producción ha evolucionado de ser una característica opcional a una necesidad crítica. Con la integración nativa de OpenTelemetry en n8n, ahora es posible obtener visibilidad completa sobre el comportamiento de workflows complejos, identificar cuellos de botella y diagnosticar fallos con precisión quirúrgica.
Este tutorial te guiará paso a paso para implementar instrumentación completa usando n8n OpenTelemetry, desde la configuración inicial hasta técnicas avanzadas de monitoreo en producción.
Configuración inicial de OpenTelemetry en n8n
Instalación y configuración básica
Para habilitar OpenTelemetry en tu instancia n8n, necesitas configurar las variables de entorno apropiadas:
bash
Variables básicas de OpenTelemetry
N8N_OTEL_ENABLED=true
OTEL_SERVICE_NAME=n8n-production
OTEL_SERVICE_VERSION=1.0.0
OTEL_ENVIRONMENT=production
Configuración del exportador OTLP
OTEL_EXPORTER_OTLP_ENDPOINT=http://jaeger:14268/api/traces
OTEL_EXPORTER_OTLP_HEADERS="api-key=your-api-key"
Configuración avanzada de sampling
Para entornos de producción con alto volumen, configura el sampling para controlar la cantidad de trazas:
bash
Sampling probabilístico del 5%
OTEL_TRACES_SAMPLER=probabilistic
OTEL_TRACES_SAMPLER_ARG=0.05
Sampling por rate limiting (100 trazas por segundo)
OTEL_TRACES_SAMPLER=rate_limiting
OTEL_TRACES_SAMPLER_ARG=100
Instrumentación de workflows y nodos
Trazas automáticas por ejecución
n8n genera automáticamente spans para cada ejecución de workflow y nodo individual. Cada span incluye:
– Workflow span: Duración total de la ejecución
– Node spans: Tiempo de procesamiento por nodo
– HTTP spans: Llamadas a APIs externas
– Database spans: Operaciones de base de datos
Añadir contexto personalizado
Puedes enriquecer las trazas con metadatos específicos usando el nodo Code:
javascript
// Añadir atributos personalizados al span actual
const { trace } = require('@opentelemetry/api');
const span = trace.getActiveSpan();
if (span) {
  span.setAttributes({
    'workflow.customer_id': $json.customer_id,
    'workflow.order_value': $json.total_amount,
    'workflow.processing_type': 'batch'
  });
}
return $input.all();
Instrumentación de nodos HTTP personalizados
Para nodos HTTP que realizan llamadas críticas, añade instrumentación específica:
javascript
// En un nodo Code antes de HTTP Request
const { trace } = require('@opentelemetry/api');
const tracer = trace.getTracer('n8n-custom');
const span = tracer.startSpan('api.payment.process', {
  attributes: {
    'http.method': 'POST',
    'http.url': 'https://api.payment.com/process',
    'payment.amount': $json.amount,
    'payment.currency': $json.currency
  }
});
// El span se cerrará automáticamente después del nodo HTTP
return $input.all();
Monitoreo de métricas de rendimiento
Configuración de métricas personalizadas
n8n OpenTelemetry puede exportar métricas además de trazas:
bash
Habilitar exportación de métricas
N8N_OTEL_METRICS_ENABLED=true
OTEL_EXPORTER_METRICS_ENDPOINT=http://prometheus:9090/api/v1/write
Métricas clave para monitorear
Estas son las métricas más importantes que debes rastrear:
1. Latencia por nodo: Tiempo promedio de ejecución
2. Throughput de workflows: Ejecuciones por minuto
3. Error rate: Porcentaje de fallos por tipo
4. Queue depth: Trabajos pendientes en cola
5. Resource utilization: CPU y memoria por workflow
Alertas basadas en SLOs
Configura alertas proactivas basadas en Service Level Objectives:
yaml
Ejemplo de configuración Prometheus
groups:
  - name: n8n.slos
    rules:
      - alert: WorkflowLatencyHigh
        expr: histogram_quantile(0.95, n8n_workflow_duration_seconds) > 30
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Workflow latency P95 above 30s"

      - alert: WorkflowErrorRateHigh
        expr: rate(n8n_workflow_errors_total[5m]) > 0.05
        for: 2m
        labels:
          severity: critical
Debugging avanzado con trazas distribuidas
Correlación de errores
Cuando un workflow falla, OpenTelemetry permite rastrear el error exacto:
javascript
// Manejo de errores con contexto de traza
try {
  // Lógica del nodo
  const result = await processData($json);
  return result;
} catch (error) {
  const { trace } = require('@opentelemetry/api');
  const span = trace.getActiveSpan();

  if (span) {
    span.recordException(error);
    span.setStatus({
      code: trace.SpanStatusCode.ERROR,
      message: error.message
    });
    span.setAttributes({
      'error.type': error.constructor.name,
      'error.input_data': JSON.stringify($json)
    });
  }

  throw error;
}
Análisis de dependencias
Usa el service map generado por las trazas para identificar:
– Servicios críticos: APIs con mayor impacto en latencia
– Puntos de fallo: Servicios con alta tasa de errores
– Cuellos de botella: Nodos que limitan el throughput
Integración con herramientas de observabilidad
Jaeger para análisis de trazas
Jaeger proporciona una interfaz visual excelente para analizar trazas:
yaml
docker-compose.yml para Jaeger
version: '3.8'
services:
  jaeger:
    image: jaegertracing/all-in-one:latest
    ports:
      - "16686:16686"
      - "14268:14268"
    environment:
      - COLLECTOR_OTLP_ENABLED=true
Grafana para dashboards
Crea dashboards específicos para n8n workflows:
json
{
  "dashboard": {
    "title": "n8n Workflows Observability",
    "panels": [
      {
        "title": "Workflow Execution Rate",
        "targets": [
          {
            "expr": "rate(n8n_workflow_executions_total[5m])"
          }
        ]
      },
      {
        "title": "Average Node Latency",
        "targets": [
          {
            "expr": "histogram_quantile(0.50, n8n_node_duration_seconds)"
          }
        ]
      }
    ]
  }
}
Optimización de rendimiento basada en observabilidad
Identificación de cuellos de botella
Usa las métricas de OpenTelemetry para optimizar workflows:
1. Análisis de latencia: Identifica nodos lentos
2. Paralelización: Optimiza flujos secuenciales innecesarios
3. Caching: Implementa cache en nodos con datos repetitivos
4. Batch processing: Agrupa operaciones similares
Técnicas de optimización
Basándote en los datos de observabilidad:
javascript
// Implementar cache inteligente basado en métricas
const cacheKey = api_${$json.endpoint}_${$json.params};
const cachedResult = await $cache.get(cacheKey);
if (cachedResult && Date.now() - cachedResult.timestamp < 300000) {
  // Cache hit - registrar métrica
  const { metrics } = require('@opentelemetry/api');
  const meter = metrics.getMeter('n8n-cache');
  const cacheHits = meter.createCounter('cache_hits_total');
  cacheHits.add(1, { endpoint: $json.endpoint });

  return cachedResult.data;
}
// Cache miss - continuar con API call
Mejores prácticas para producción
Configuración de sampling inteligente
Implementa sampling adaptativo basado en condiciones:
bash
Sampling condicional por criticidad
OTEL_TRACES_SAMPLER=jaeger_remote
OTEL_TRACES_SAMPLER_ARG="endpoint=http://jaeger:14268/api/sampling"
Gestión de recursos
Para evitar impacto en rendimiento:
– Batch export: Agrupa spans antes de enviar
– Async processing: Procesa trazas de forma asíncrona
– Resource limits: Limita memoria usada por el SDK
– Graceful degradation: Desactiva tracing si hay problemas
Seguridad y compliance
Asegura que la instrumentación cumple requisitos:
javascript
// Sanitizar datos sensibles en spans
const sanitizeAttributes = (data) => {
  const sanitized = { ...data };
  delete sanitized.password;
  delete sanitized.credit_card;
  delete sanitized.ssn;

  // Enmascarar emails
  if (sanitized.email) {
    sanitized.email = sanitized.email.replace(/(.{2}).*@/, '$1***@');
  }

  return sanitized;
};
span.setAttributes(sanitizeAttributes($json));
Para implementar observabilidad robusta en tus automatizaciones n8n, considera Arquitectura de microservicios con límites claros: bounded contexts que escalan y explora nuestras soluciones-devops especializadas.
Conclusión
La implementación de n8n OpenTelemetry transforma radicalmente la capacidad de monitorear y optimizar automatizaciones en producción. Con trazas distribuidas, métricas granulares y debugging contextual, puedes garantizar la confiabilidad y rendimiento de workflows críticos.
La inversión inicial en instrumentación se traduce en reducción significativa del tiempo de resolución de incidentes, mejor comprensión del comportamiento del sistema y capacidad proactiva de optimización.
¿Necesitas implementar observabilidad completa en tus automatizaciones n8n? Nuestro equipo especializado puede ayudarte a diseñar e implementar una estrategia de monitoreo robusta. [Contáctanos](/contacto/) para una consultoría personalizada sobre observabilidad en automatizaciones empresariales.